降噪原理:噪音配置、AI 与语音再生成
降噪会把录音拆成许多很窄的频段,从低沉的嗡嗡声到尖细的嘶嘶声,每时每刻判断每个频段里有多少是噪音,再把这些部分压低,让人声凸显出来。老式工具通过几秒钟没有说话的片段来认识噪音;AI 模型则从数千小时的示例中学会了人声和噪音听起来是什么样子,能自行完成这项工作;修复模型更进一步,会重建人声本身。
最后更新于 · 作者:Routes Software,Denoise 的开发者
一段录音同时包含许多频率
任何声音都是多种频率的混合。嗡嗡声是一个低沉的音调,嘶嘶声是一片散开的高音,而人声是一组随每个音节变化的音调。如果把录音画成图,让时间从左往右走、音高从下往上升,语音就会显示为一道道明亮的条纹,持续稳定的噪音则像条纹背后的一层薄雾。
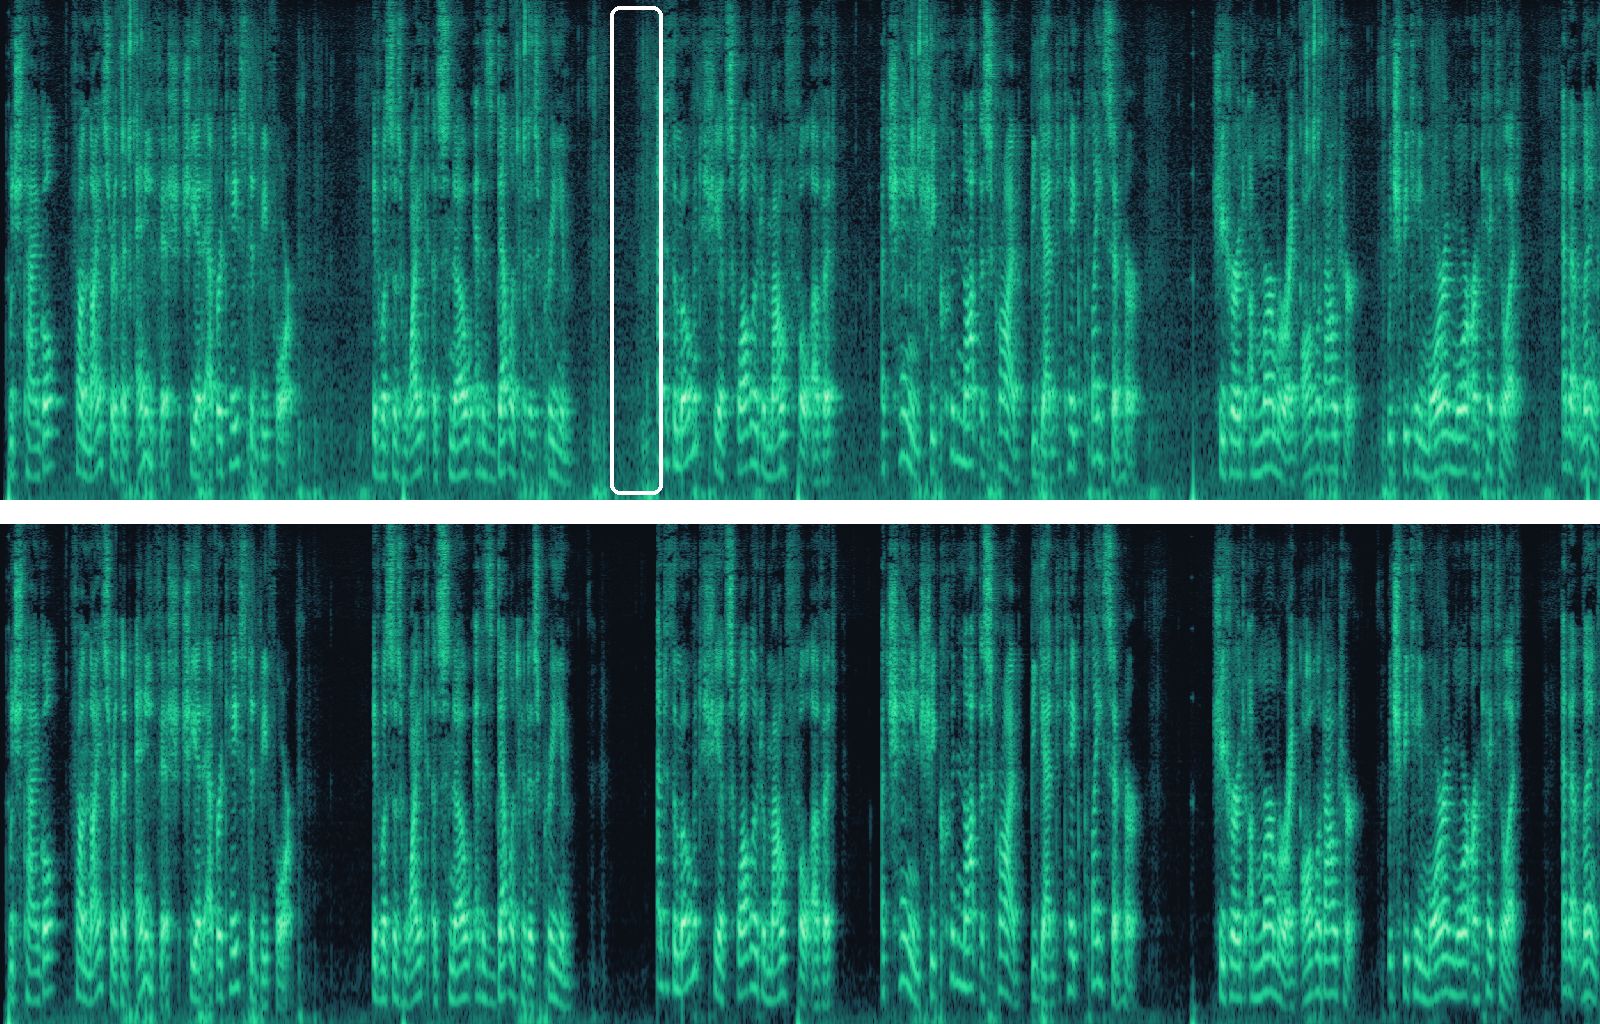
1. 噪音配置:先认识噪音,再在整段录音中去除它
经典方法只需要你提供一样东西:几秒钟没有说话、只有噪音的片段。在 Denoise 中,这就是经典引擎:它会请你标出这样一段,还会推荐几段。它测量这一段里每个频段的噪音有多响,这份测量结果就是噪音配置,相当于噪音的“指纹”;然后在整段录音中把这些频段压低相应的量。压低的幅度由降噪强度决定。
这种方法最适合始终不变的噪音:风扇、空调、电流嗡嗡声、磁带嘶嘶声。对于时有时无的噪音,比如车流声、风声或人们的交谈声,它就力不从心了,因为一份噪音配置无法描述全部噪音。而且,由于它在各处压低的都是相同的频段,调得太狠就会留下一种像在水里、忽高忽低颤动的声音,并在人声和噪音共用频率的地方让人声变得单薄。
2. AI 降噪:思路相同,但由 AI 替你完成
AI 降噪模型做的是同样的事,但不需要你提供噪音样本。它们用数千小时的干净语音训练而成,这些语音里混入了各种各样的噪音,因此它们学会了在上面那种图里,人声是什么样子、噪音又是什么样子。每隔几毫秒,它们就逐个频段估算声音中有多少是人声,保留这部分,压低其余部分。由于它们每时每刻都在重新判断,所以能跟上不断变化的噪音:驶过的汽车、一阵风、开关门声。
在 Denoise 中,AI · Auto 默认做的就是这件事;DPDFNet 和 DeepFilterNet 模型也可以单独选用,分别是 AI · DPDFNet 和 AI · Fast Denoise;AI · aTENNuate 则直接处理声波本身,而不是处理频段。它们都只处理录下来的声音,所以不会添加没人说过的话。降噪强度决定去掉多少噪音,保留一点往往听起来更自然。
3. 修复:重建录音丢失的部分
有些录音不只是多了噪音,还丢失了一部分人声。电话通话、老式录音笔或高强度压缩都可能截掉较高的频率,所以即使在安静的房间里,人声听起来也发闷。恢复语音质量会根据剩下的部分,重建缺失的高频部分。它是在人声上做补充,而不是替换人声,所以词语仍是当时说出的那些;它补上的是听起来合理的明亮感,而不是已经丢失的细节。
4. 再生成:根据对原声的描述,生成新的声音
最新的修复模型走得更远。它们会听取受损的录音,推断出它们认为录音里说了什么,然后像语音合成器那样,把这段话重新生成为一段全新的录音。正因如此,AI · Sidon 才能挽救降噪模型无能为力的音频:严重失真、削波或非常发闷的人声。
问题在于,结果只是模型的最佳猜测。当原始录音缺失得太多时,再生成模型可能会生成听起来很对的语音,音色和节奏都没错,说出的却是没人说过的音节,有时甚至完全是胡言乱语。我们在 Denoise 以前使用的模型 VoiceFixer 上就听到过这种情况:处理一段严重受损的讲座录音时,它生成的语音听起来很清晰,却毫无意义。取代它的 Sidon 在设计和测试时都以保留原话为目标,但没有哪个再生成模型能完全避免这个问题,所以凡是重要的内容,请核对其中的人名和数字,并且只在普通降噪无能为力时才使用再生成。
效果能有多好,取决于什么
上面介绍的每一种方法,都只能利用录音中仍然保留的内容。最重要的有四点:
- 人声保留了多少。如果部分人声根本没被录下来,或者被低质量的格式丢掉了,降噪就无法找回;只有修复才能补上一个听起来合理的版本。
- 噪音和人声相比有多响。当噪音和人声一样响甚至更响时,两者的大部分频率是重叠的,去除噪音时也会连带去掉部分人声:结果听起来单薄、发闷,或者像机器人。
- 录音是否削波(爆音)。如果声音对麦克风或录音电平来说太响,声波的峰值就会被削平。这种噼啪作响的失真已经成了人声的一部分,而不是独立的噪音,所以降噪模型会把它保留下来;只有再生成才能把它重新画出来。
- 背景里还有什么听起来像人声。其他人的说话声,或者带演唱的音乐,在任何方法看来都像语音,所以会残留一部分。如果是音乐,可以改用 AI · Music 把人声和乐器分离开。
回声不是噪音
房间里的回声,也就是混响,是人声本身经墙壁、天花板和地板反射后,稍晚片刻再次传来的声音。由于它和人声是同一种声音,所以比噪音更难去除:AI 降噪模型能减弱一部分,但在礼堂、楼梯间或空荡荡的房间里,字词会糊成一片,任何设置都无法让它们完全恢复清晰。解决办法是缩短距离:麦克风离嘴越近,人声相对于回声就越响。
最好的降噪,在录音之前就开始了
软件能挽救录音,但找不回从未录下的声音。下面几个小习惯,比任何设置都管用:
- 把麦克风靠近一些。拿在说话人旁边的手机,录音效果胜过放在房间另一头桌上的手机。拍采访和视频时,在说话人的衣领上别一个夹式麦克风(领夹麦),无论有线还是无线,都是单项改进中效果最大的。
- 给麦克风挡风。在户外,给外接麦克风套上海绵或毛绒防风罩会有帮助;如果用手机录,就背对着风,或者用手或墙角为手机挡风。
- 留意录音电平。如果电平表顶到了最上面,声音就会削波。音量稍微偏小一点更保险,因为偏小的音量事后可以调大,而削波无法挽回。
- 尽量选最安静的地方。录音时关掉风扇和空调,并远离车流和正在运转的机器。
- 软装多的房间回声小。家具、窗帘、地毯和书架会吸收回声;瓷砖、玻璃和空房间则会把回声反射回来。
听听区别
常见问题
AI 降噪会凭空编造词语吗?
AI · Auto、AI · DPDFNet、AI · Fast Denoise 和 AI · aTENNuate 这类降噪模型不会:它们只处理录下来的声音,保留人声,压低其余部分。AI · Sidon 这类再生成模型会生成新的音频,在严重受损的录音上,可能说出原本没说过的内容,所以使用后请核对重要的词语。
为什么降噪后我的声音听起来发闷,或者像机器人?
通常是因为噪音和人声一样响,去除噪音时连带去掉了部分人声。试着在 Denoise 中调低降噪强度,或者换一个引擎。如果录音在降噪之前就已经发闷,请打开恢复语音质量。
降噪能去除回声吗?
部分可以。AI 降噪模型能减弱一些房间回声,但严重的混响是延迟到达的人声本身,无法完全去除。靠近说话人录音才是可靠的解决办法。
失真或削波的录音能修好吗?
降噪做不到,因为削波改变的是人声本身,而不是额外加入了噪音。再生成(在 Denoise 中就是 AI · Sidon)可以把削波的语音重新画出来,但存在上文所说的编造声音的风险。为了避免削波,录音时把音量放小一点。
应该先用哪个引擎?
先用 AI · Auto:它会为你的录音挑选模型和设置。如果 AI 处理后仍残留持续的嗡嗡声,就用经典;如果人声不只是有噪音,而是失真或严重受损,就用 AI · Sidon。
是事后降噪好,还是一开始就录干净好?
尽量录得干净:降噪能挽救录音,但找不回从未录下的声音。把麦克风挪近一点,比任何设置都管用。
参考来源
- Suppression of acoustic noise in speech using spectral subtraction(S. Boll,1979)
- DeepFilterNet(开源)
- DPDFNet: Boosting DeepFilterNet2 via Dual-Path RNN
- aTENNuate: Optimized Real-time Speech Enhancement with Deep SSMs on Raw Audio
- AP-BWE:语音带宽扩展(开源)
- Sidon: Fast and Robust Open-Source Multilingual Speech Restoration for Large-scale Dataset Cleansing